
9社でコンソーシアム、v1.0を発表
AIモデルを動かす公開の推論ソフト「SGLang」の開発チームは、米サンフランシスコで11月12〜13日(米国時間)に開いた初の「SGLang Summit」で、次の版「SGLang v1.0」を発表した。あわせて、NVIDIA、AMD、Intel、Google、Meta、Thinking Machines Lab、Cloudflare、Modal、RadixArkの9社を創設メンバーとする「SGLang Consortium」を立ち上げた。SGLangを手がける非営利団体LMSYS Orgが、17日(米国時間)に公式ブログでサミットを振り返った。
推論ソフトは、学習を終えたAIモデルをGPUなどの半導体の上で動かし、利用者の質問に答えさせるためのソフトだ。同じ機器でどれだけ速く、安く答えを返せるかを左右する。LMSYS Orgは、SGLangが機械学習の基盤ソフトPyTorchの関連プロジェクトの一つで、数十万基のGPUで動いているとしている。
SGLangの公式Xは日本時間18日1時59分、サミットの成果を次のように投稿した。
2,000+ people. Two days. The first SGLang Summit. Together, we announced SGLang v1.0, released Miles v0.2, and launched the SGLang Consortium with nine founding members: @nvidia, @AMD, @intel, @Google, @Meta, @thinkymachines, @Cloudflare, @modal, and @radixark. SGLang is now used by 332 organizations. At Meta, it powers production inference for products serving billions of users. Teams from Modal, Cloudflare, LinkedIn, and others shared their production lessons. Across 90+ technical talks and six hands-on workshops, the community explored what comes next for inference, reinforcement learning, and AI agents. To everyone building, deploying, and contributing: thank you for making this possible. Explore the announcements, engineering lessons, and moments from SGLang Summit 2026 in the link below.
コンソーシアムは年2回のロードマップ会議、判断はメンテナーに
コンソーシアムの発足は、米国時間11月12日(日本時間13日)のサミット初日の基調講演で発表された。LMSYS Orgは同日の発表で、9社がSGLangのメンテナー(開発の中心となる管理者)とともに、プロジェクトのロードマップ(開発計画)作りに加わると説明した。
仕組みは次のとおりだ。創設メンバーの各社は技術担当者を1人決め、年2回のロードマップ会議に参加する。貢献の形は、技術の知見、本番運用からの意見、試験用の資源、共同開発のいずれかとしている。会議の合間には作業部会で協力でき、ロードマップの方向と進み具合は公開で知らせる。
重点を置く分野には、最先端モデルへの対応、推論(考えながら答える)や画像などを扱うマルチモーダルの処理、複数の機器にまたがる分散推論、半導体ごとの最適化を挙げた。技術判断とコードの受け入れの責任は引き続きSGLangのメンテナーが持ち、プロジェクトは誰でも参加できる形を保つとしている。
LMSYS Orgは11月16日(米国時間)に発表を更新し、Thinking Machines Labを創設メンバーに加えた。今回の顔ぶれは、この更新後の9社だ。
会費や各社の拠出額、会議での議決の方法、メンバーを増やす条件は、発表に書かれておらず、確認できていない。
発表には各社の幹部のコメントが寄せられた。NVIDIAのイアン・バック副社長は、より良いソフトで開発者がNVIDIAの計算資源からより多くの性能を引き出せるようになり、推論の費用が下がればAIをより多くの組織が使えるようになると述べた。AMDのリサ・スー最高経営責任者(CEO)はビデオでメッセージを寄せ、同社は「big believers in open」(オープンを強く信じている)とし、SGLangの開発に、より直接に貢献していく考えを示した。
LMSYS Orgは発表の中で、2026年にはAIの計算全体のおよそ3分の2を推論が占め、2025年の約半分から増えるとする米Deloitteの見通しを引いている。
v1.0は安定性を優先、公開日は決まっていない
v1.0は、新しい機能を足すより、既存の機能を固める版と位置づけられている。GitHubの公式リポジトリに11月12日(米国時間)に立てられたリリース追跡(「SGLang 1.0 Release Tracker」)は、v1.0を「stability release」(安定性のための版)と呼んでいる。
柱は3つだ。1つ目は、既存の機能の不具合を直し、試験を増やすこと。2つ目は、利用者が指定した設定をSGLangが黙って変えたり、モデルの扱いを黙って落としたりする動作をやめ、どの設定が原因かを示すエラーで止めること。3つ目は、1.x系の間に変えない部分と、試験的な部分を決める互換性の方針を文書にすることだ。
リリース追跡は、黙って設定を変える動作を9件挙げている。たとえば、出力の長さの上限(max_new_tokens)が、記憶領域の容量に合わせて知らせなしに切り詰められ、応答が途中で終わるケースがある。AMDのGPU「Instinct MI35x」で、Alibabaの「Qwen3.5」のモデルが既定で別の数値形式に圧縮されるケースも含まれる。
新たに対応するモデルは、Moonshot AIのKimi K3.1と、AMDのGPUで動かすMetaの「Muse Spark」に限られる。それ以外に、0.5系でできなかったことは増やさないとしている。
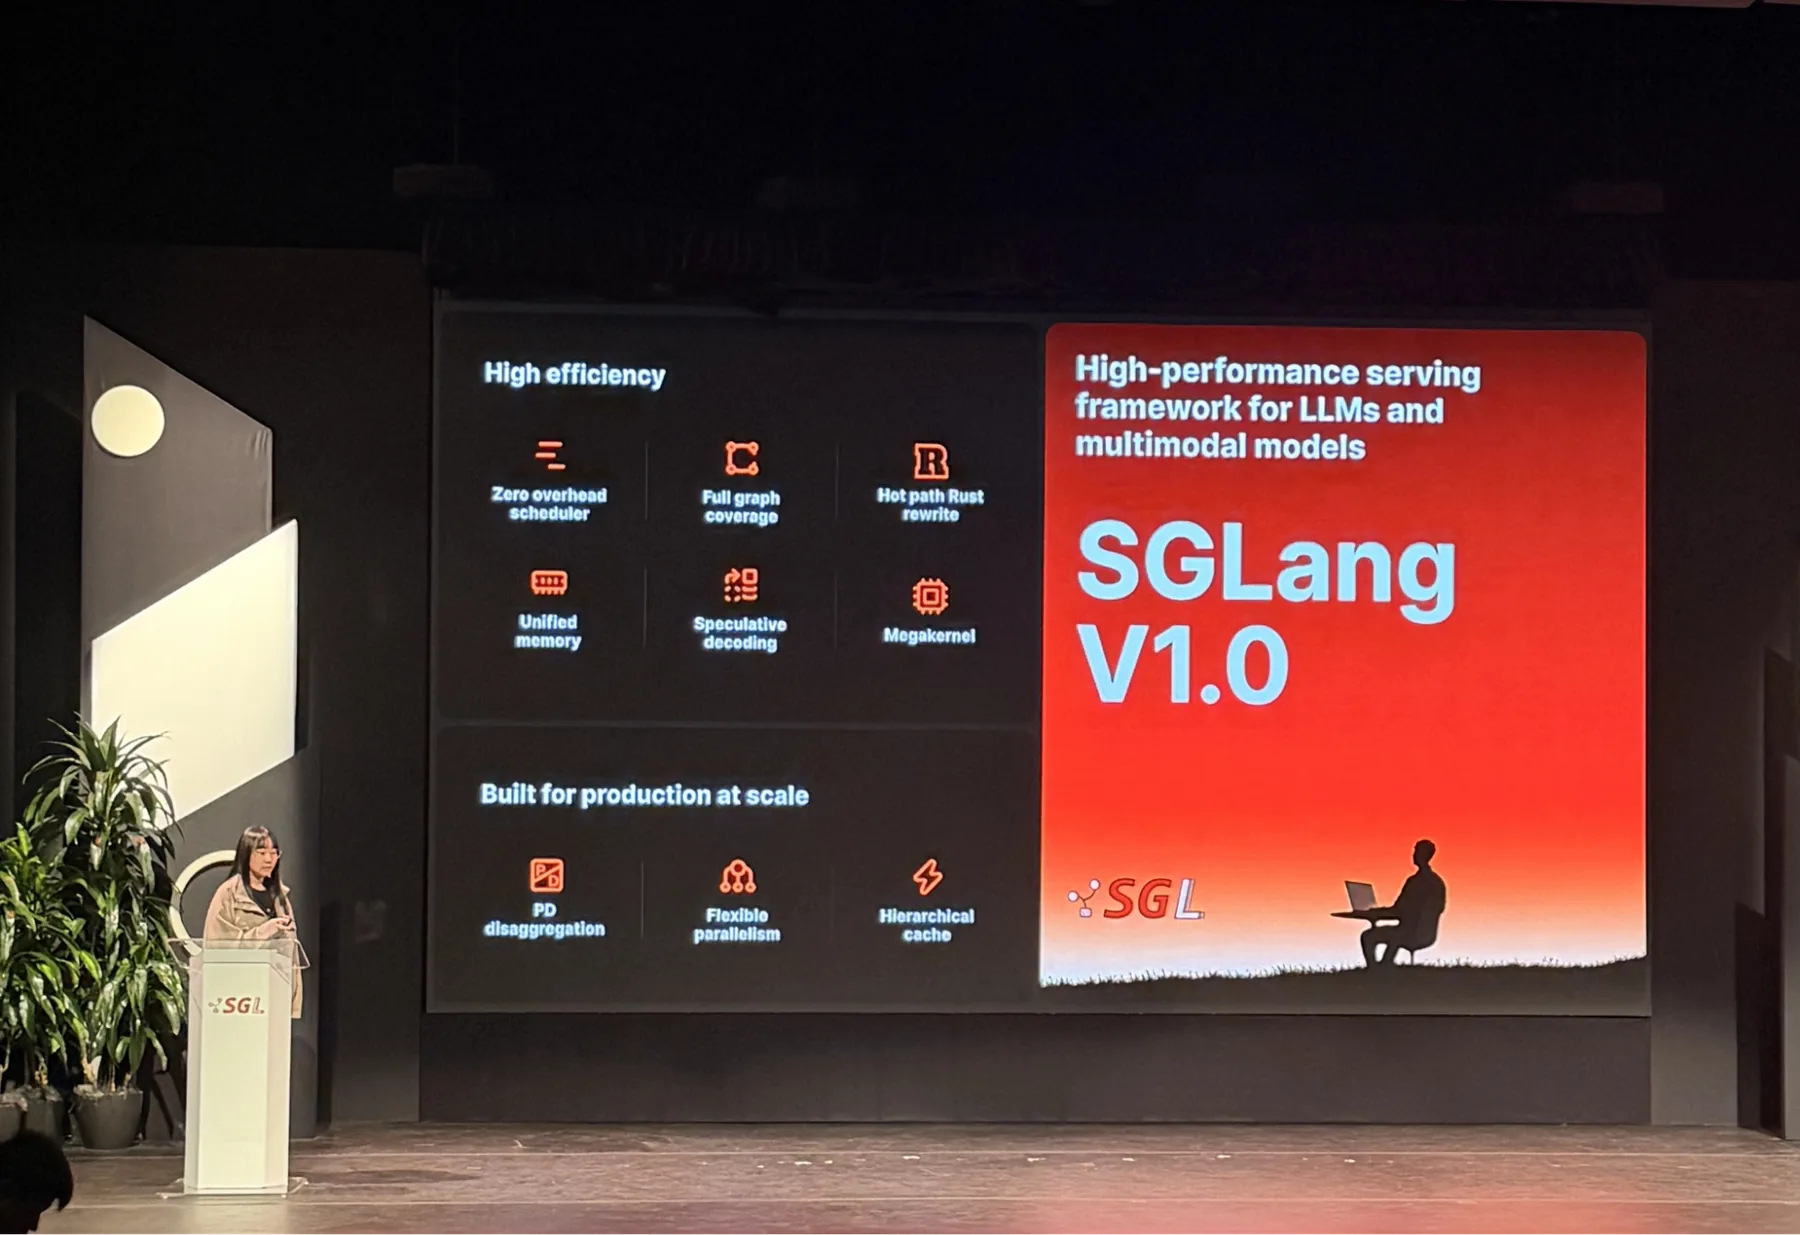
ただ、v1.0はまだ公開されていない。日本時間11月18日時点で、リリース追跡は「Open」(未完了)の状態で、公開前に終える必要がある「Required」の項目の多くが「In progress」(作業中)になっている。リリース用の分岐を作ってから行う確認の作業はまだ始まっていない。公開の日程は「決まりしだい載せる」としている。
基調講演では、開発の進め方も変わったと説明した。LMSYS Orgによると、SGLangに取り込まれる変更の提案(プルリクエスト)は、すでに大半をAIエージェントが作っている。今後は、コードを書き、提案を確かめ、試験を作るAIの道具の開発に取り組むという。
0.5系からの移行では設定の見直しが要る
リリース追跡は、0.5系から移る利用者に対応が要る変更を6つ挙げている。
最も大きいのは、利用者の要求を複数のサーバーに振り分ける部品「sgl-model-gateway」の廃止だ。代わりにRust言語で書いた「sgl-router」を使い、SGLangのDockerイメージ(配布用のひな形)に入る部品もsgl-routerに替わる。sgl-model-gatewayにしかない機能は、まだsgl-routerにない。
これまで警告を出して自動で直していた設定は、エラーで止まるようになる。誤った値を含む要求も、受け付けの段階で拒まれる。モデルの重みの更新やキャッシュの管理など、サーバーの状態を変えたり調べたりする管理用の操作には、専用の鍵(--admin-api-key)が要るようになり、通常のAPIの鍵では使えなくなる。0.5系で使わないよう告知していた設定項目も削除する。
移行の手引きは、リリース追跡の時点では公開されていない。古い2つの設定項目を残すかどうかや、sgl-routerの配布名など、4つの点がまだ決まっていない。
Metaは数十億人向けの製品で利用、332組織に
プロジェクトによると、SGLangを使う組織は、この1年で少数の早期利用者から332に増えた。LMSYS Orgはコンソーシアムの発表で、Meta、Microsoft、Google、Amazon、Thinking Machines Lab、Cloudflare、Reflection、Modalの名前を利用企業として挙げている。
Metaでは、SGLangが数十億人の利用者を抱える製品の推論を支えている。サミットで登壇したMetaの技術者は、「Muse App」や「Muse Code」、Metaのアプリ群、画像と動画の処理に使い、NVIDIAとAMDのGPU、GoogleのTPU、Meta自社の半導体「MTIA」にまたがって動かしていると説明した。LMSYS Orgによると、Metaは以前の推論の仕組みから移ったことで、GPUについて「more than 2× GPU savings」(2倍を超える節約)を得たと報告した。具体的な台数や費用は示していない。
ModalやCloudflare、LinkedIn、Fireworks、Basetenなどのチームも、本番運用で得た教訓を共有した。
一方で、SGLangから離れた例もある。SpaceXSI(SpaceX Super Intelligence)を率いるイーロン・マスク氏は11月10日、推論に使っていたSGLangをやめ、仕組みを一から書き直したとXに投稿していた。
Miles v0.2を公開、半導体各社の対応広がる
サミットでは、SGLangを使ってAIモデルを強化学習(答えの良しあしに応じてモデルを仕上げる学習)で仕上げる仕組み「Miles」の新版v0.2も公開した。NVIDIAとAMDのGPU、GoogleのTPUで動き、AmazonのAI半導体「AWS Trainium」にも近く対応する。文章のほか、画像、動画、音声の強化学習も扱えるようになった。
半導体の各社も対応を示した。NVIDIAは、企業向けの推論の部品「NVIDIA NIM」の認定版に、SGLangを使うと発表した。IntelとRadixArkは、Intelの半導体向けにSGLangを最適化する協力を発表した。RadixArkとAmazonのAnnapurna Labsが共同で開発した、Trainium向けの「SGLang-Neuron」v0.1.0も試験公開された。
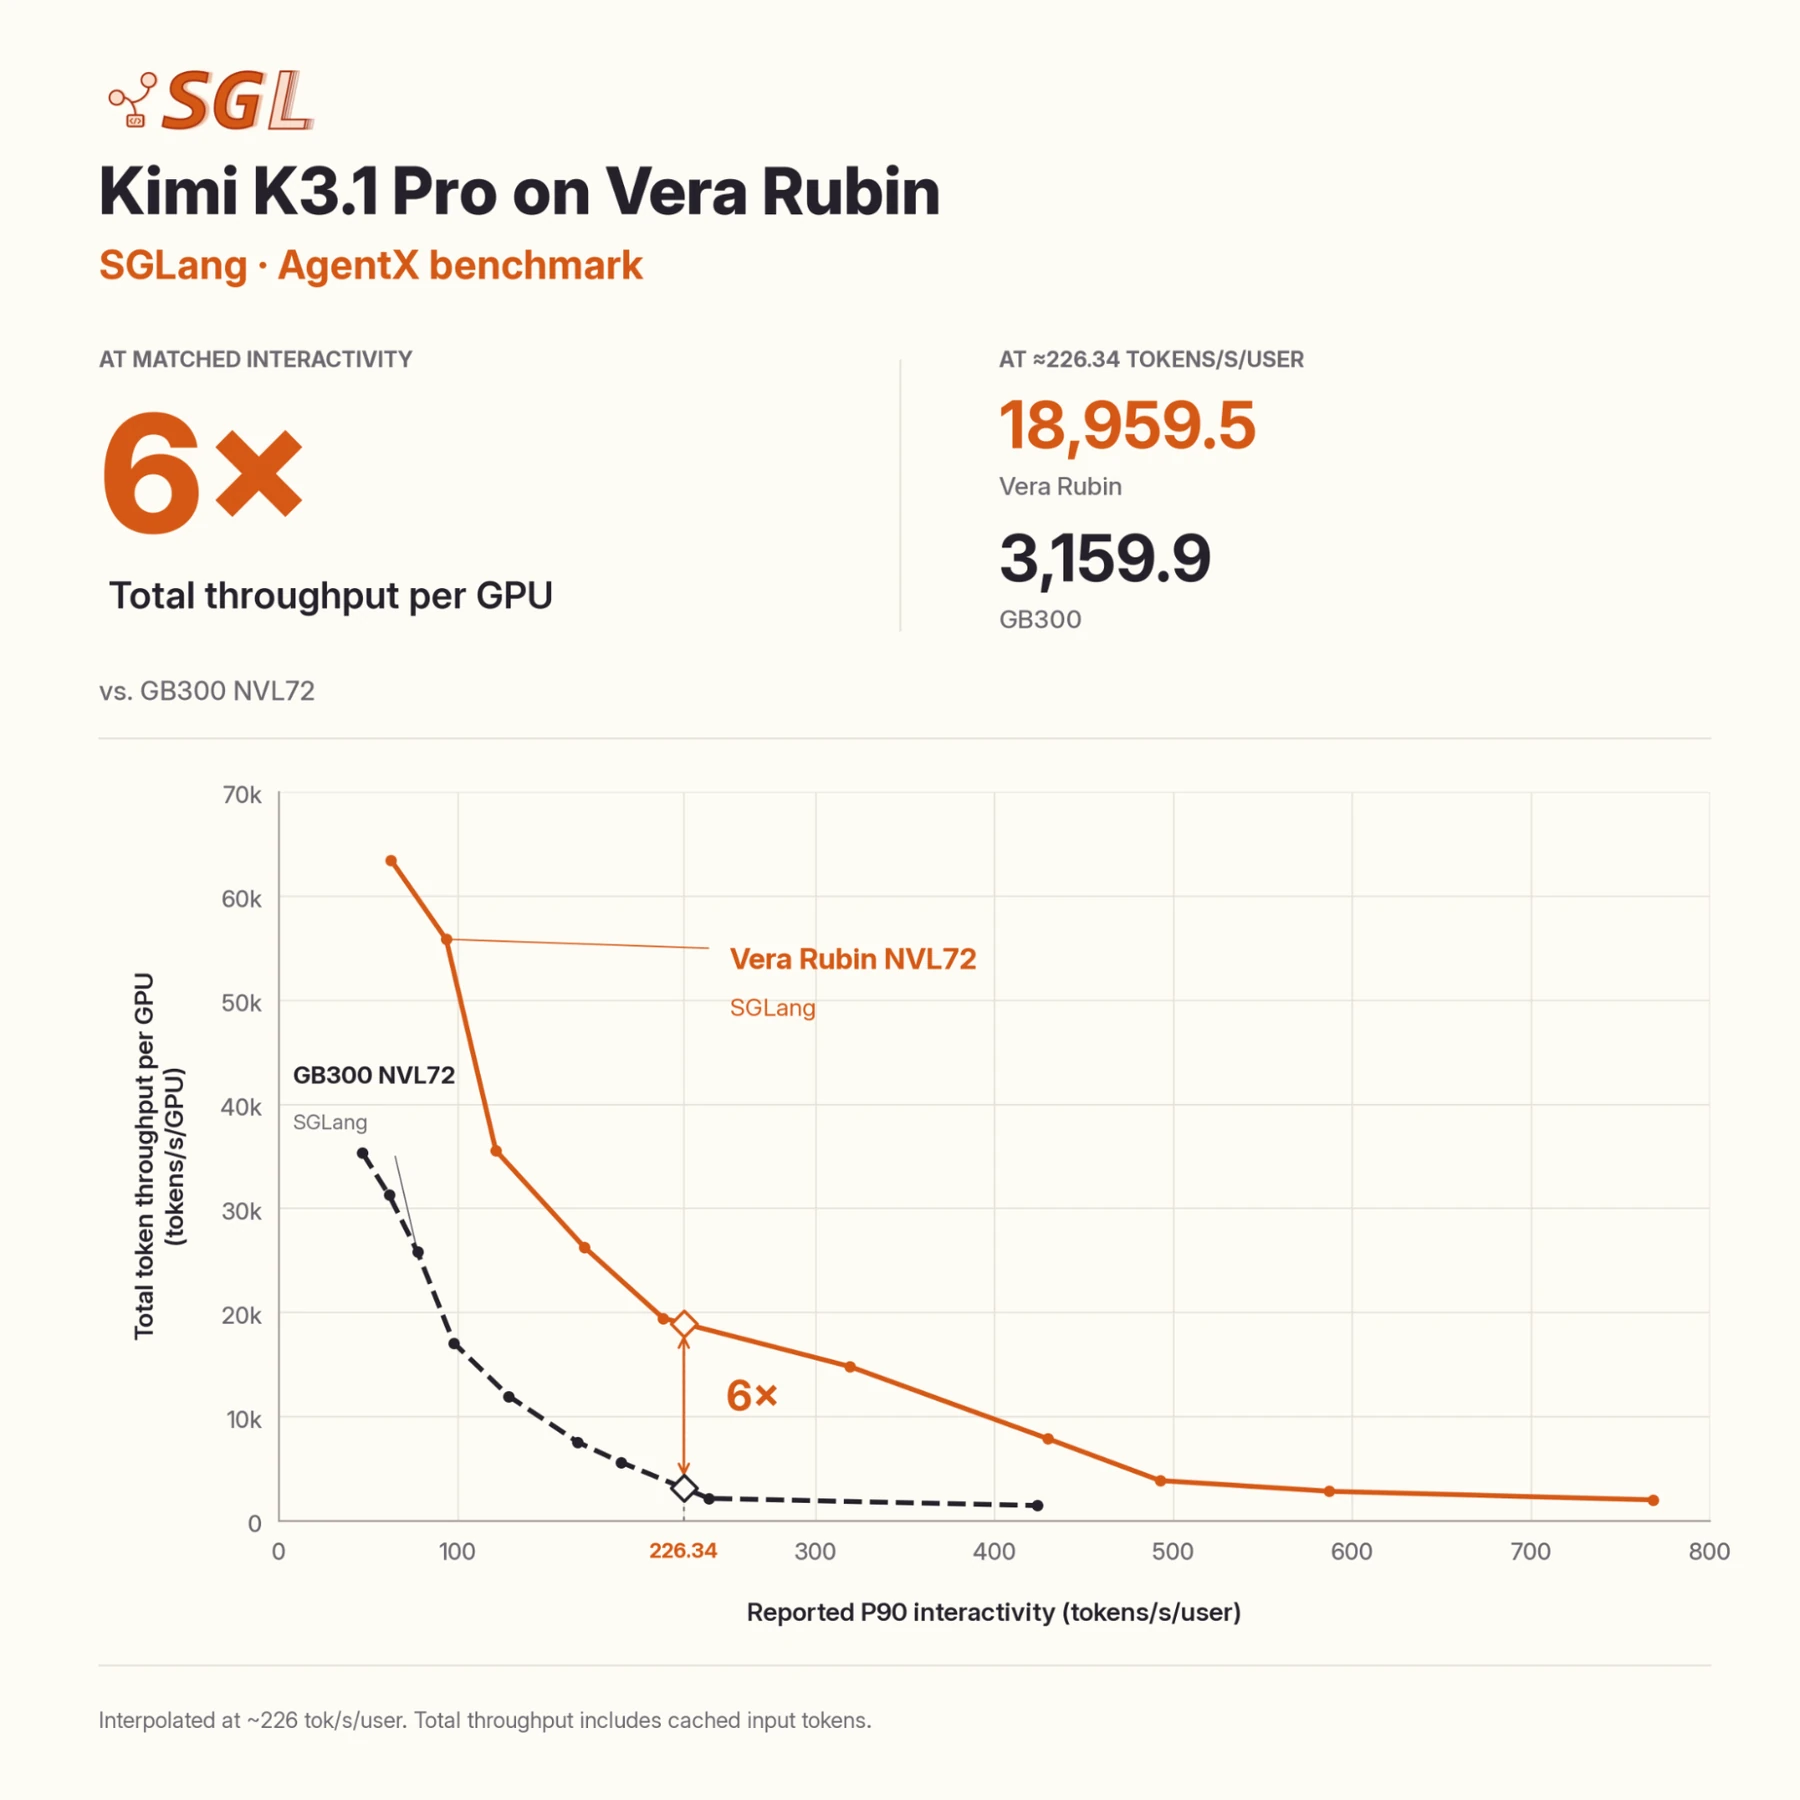
LMSYS Orgのブログは、NVIDIAの講演を紹介する項で、同社の次世代の「Vera Rubin」を使った結果の図を載せた。エージェント向けの試験「AgentX」で、Moonshot AIのKimi K3.1 ProをSGLangとNVIDIA Dynamoで動かした場合、利用者1人あたりの応答の速さをそろえたときのGPU1基あたりの処理量が、「GB300 NVL72」と比べて最大6倍になったという。処理量にはキャッシュ済みの入力も含む。SGLangの図に示された数字で、第三者の検証は確認できていない。
基調講演では、CloudflareとNEAR AIが報告した脆弱性と、その修正も取り上げた。SGLangの開発チームは、セキュリティの確認に協力する相手を求めた。
2000人超が参加、90超の講演
プロジェクトによると、サミットには開発者や研究者など2000人超が集まった。90を超える技術講演と、6つの実習を開いた。主会場では、Intelのリップブー・タンCEO、OpenAIのリリアン・ウェン氏、Thinking Machines Labのスミス・チンタラ最高技術責任者(CTO)、Perplexityのアラビンド・スリニバスCEOらが話した。
講演の録画と資料は、近く公開するとしている。


