
図面や画像を読む作業の新しい評価
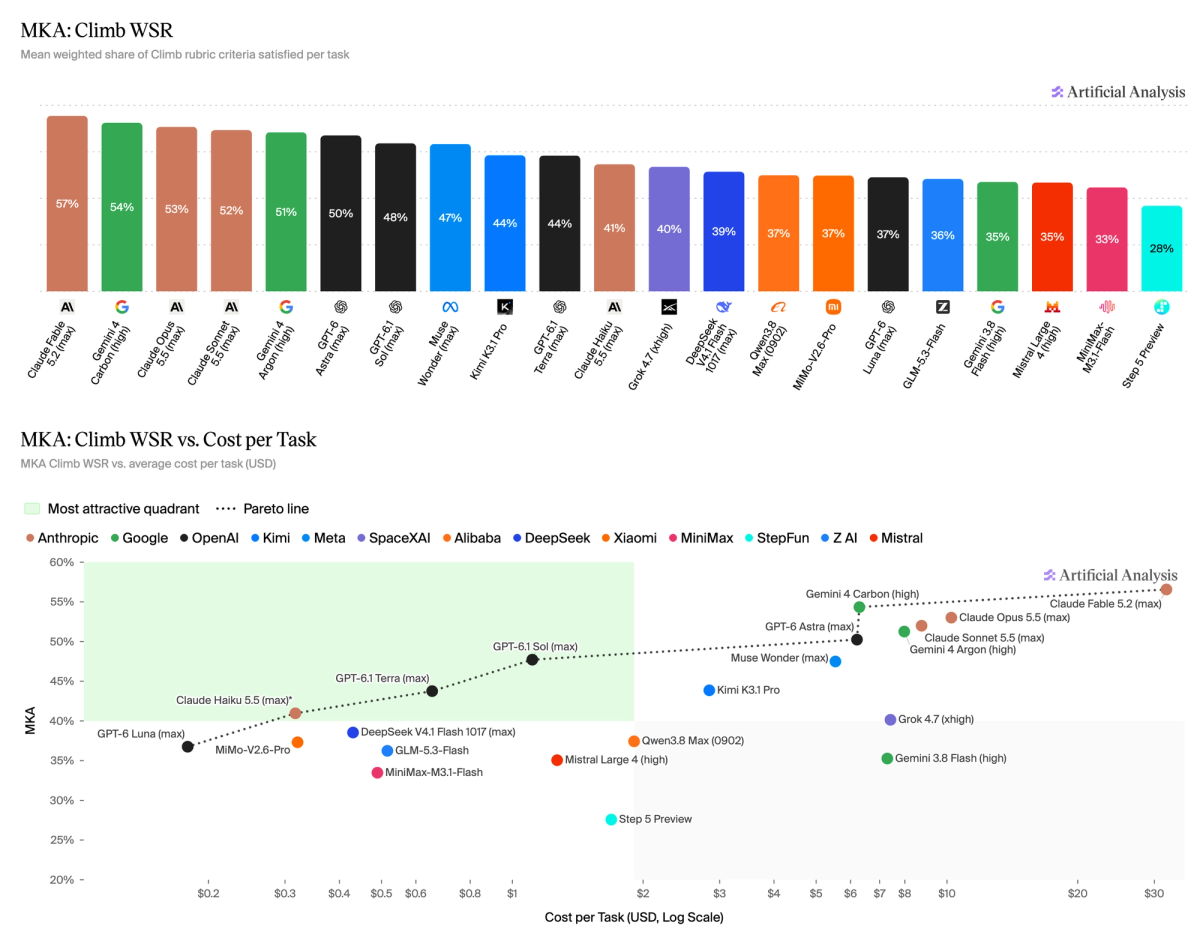
Google DeepMindは11月10日(日本時間11日)、AIモデルを同じ条件で比べる米Artificial Analysisと共同で、AIエージェントの新しいベンチマーク「MKA(Multimodal Knowledge Agent)」を公開した。建築図面や電子回路図、X線画像、地図のような見た目の複雑なファイルを読み、表計算やスライド、報告書などの成果物を作らせて採点する。Artificial Analysisの順位表では、米AnthropicのClaude Fable 5.2が57%で首位、GoogleのGemini 4 Carbonが54%で2位、AnthropicのClaude Opus 5.5が53%で3位だった。
With @ArtificialAnlys, we built MKA (Multimodal Knowledge Agent): a benchmark for how well agents handle visually complex tasks. Everyday professional work often uses more than just text…
Googleによると、専門職の作業を測る既存のベンチマークの多くは、文章を読むだけで解ける。MKAは、画像を見なければ答えられない課題をそろえた点が新しいと説明している。
10業種200課題、採点はOpenAIのモデル
課題は、ビジネス、建設、教育、エンジニアリング、金融、医療、法務と行政、物流と地図、科学、ソフトウェアとデータの10業種で、各20課題ある。83職種の専門家が作り、1課題は熟練者が3〜8時間かける作業にあたる。1課題に入力ファイルが2〜45個(平均7.3個)付き、88%の課題では答えを文章ではなくファイルで出させる。
採点基準は1課題に平均約70項目あり、事実の正確さに75%、見た目の作りに25%の重みを置く。採点はAIが行う。成果物のファイルを開き、ページを画像にして確かめ、表計算の数式まで調べる。Googleは採点者を「Google以外のモデル」と説明しており、技術報告書とArtificial AnalysisによるとOpenAIのGPT-6 Lunaを使う。50課題で専門家の採点と比べたところ、96.2%の項目で判定が一致した。
点数の「Climb WSR」は、難しい採点項目を重み付きで満たした割合を表す。難しい項目とは、旧世代の4モデル(Gemini 3.8 Flash、Gemini 3.6 Flash、Claude Sonnet 5.5、GPT-6.1 Sol)のうち1つでも安定して満たせなかった項目を指す。課題を完全にこなした割合ではない。すべての項目で測る「Overall WSR」では、技術報告書の4モデルはいずれも69〜74%だった。
モデルは、Artificial Analysisが開発するオープンソースの実行環境「Stirrup」で、同じ道具と作業環境、最大250手の上限のもとで動かす。200課題はArtificial Analysisが非公開で運用し、学習データへの混入を防ぐ。別に10課題をHugging Faceで公開した。
費用はGoogleが「6分の1」、Artificial Analysisは「5倍超」
1課題を解く費用は、FableとCarbonで大きく開いた。ただ、差の大きさは計算した会社で違う。
Artificial Analysisの計算では、1課題の費用はFable 5.2が31.97ドル、Carbonが6.29ドルだった。同社は、Fableが約2ポイント高い点数のためにCarbonの「5倍超」の費用をかけたと説明している。OpenAIのGPT-6.1 Solは1.11ドルで48%と、Fableの約29分の1の費用で9ポイント下にとどまった。
Googleはブログで、Carbonは最高得点のモデルに比べて平均「6分の1」の費用で課題をこなすと主張した。根拠となる技術報告書の計算では、各社の定価(プロンプトのキャッシュ込み)で1課題の費用はFableが35.28ドル、Carbonが5.63ドルで、6.26倍の開きになる。2つの計算がなぜ違うかを、両社は説明していない。
Fableの費用がかさむのは、使う量が多いためだ。技術報告書によると、Fableが1課題で使ったトークン(AIが処理する文字の単位)は4048万で、Carbonの705万の5.74倍だった。作業の手数は128.8回と46.6回、かかった時間は83.2分と29.2分だった。
API料金は100万トークンあたり、Fable 5.2が入力8ドル、出力40ドルだ。Carbonは11月30日までの導入期間が入力2ドル、出力10ドルで、その後は入力4ドル、出力20ドルになる。Googleは同じ11月10日に、Carbonを開発者や企業向けのAPIなどで一般に提供し始めた。Fable 5.2は前日の9日にAnthropicが公開したばかりだ。
上位3つの差は誤差の範囲、Googleが共同で作った評価
技術報告書によると、Fable 5.2、Carbon、Opus 5.5の点数の差は統計的に区別できない。FableとCarbonの差は2.22ポイントで、95%の信頼区間はマイナス0.94からプラス5.49ポイントにまたがる。一方、FableとCarbonはGPT-6 Astraを統計的に意味のある差で上回った。
報告書は評価の限界も挙げている。各モデルは1課題を1回だけ解き、採点も1回だけだ。専門家との一致を調べたのは50課題の重みの大きい項目だけで、細かな書式の項目に同じ一致率が当てはまるとは限らない。費用は執筆時点の定価で計算しており、料金が変われば変わる。難しい項目を選ぶ基準にした旧世代のモデルには、Geminiの2モデルが含まれる。
MKAはGoogleが共同で作った評価で、自社のCarbonが2位に入った。米Crypto BriefingはDeepMindに直接の競争上の利害があると指摘した。米TechTimesは、上位の差が実質的に引き分けだと伝えている。200課題は非公開で、外部から結果を再現することはできない。
画像を見る道具を外すと点数が下がる
Googleは技術報告書で、MKAが画像を読む力を測れていることを示す実験も公表した。Carbonから画像を見る道具を外すと、Climb-WSRは5.94ポイント下がり、作業の手数は1.28倍、出力するトークンは1.40倍に増えた。OpenAIの専門職の評価「GDPval」で同じ実験をすると、点数はほとんど変わらなかった。道具を外したCarbonは、画像を文字の絵に変えるなどして補おうとしたが、写真や医療画像の事例ではClimb-WSRが34〜72ポイント下がった。この実験はCarbonだけで行っている。
Artificial Analysisによると、業種別ではFableがソフトウェアとデータ、エンジニアリング、物流と地図、ビジネス、金融で首位だった(金融はClaude Sonnet 5.5と並ぶ)。Opus 5.5が教育と建設、Gemini 4 Argonが科学、Carbonが医療、Sonnet 5.5が法務と行政で首位に立った。成果物の形式では、Word文書とテキストファイルが最も難しく、どのモデルも52%を超えなかった。
専門職の長い作業をAIに任せて測る評価は、この1カ月で相次いでいる。米SemiAnalysisは11月1日に「GDPx」を公開し、首位のClaude Opus 5.5でも正答率は12.0%だった。米Mercorの「APEX-Agents」では、Carbonが10月30日に1位になった。


