
防御側限定から2週間で一般提供
Googleは11月10日(日本時間11日)、最上位のAIモデル「Gemini 4 Carbon」を開発者、企業、科学者、一般の利用者に提供すると発表した。APIは料金を払う開発者と企業に開放し、最上位の有料プラン「Google AI Ultra」の契約者には、Geminiアプリ、検索のAI Mode、開発ツールのAntigravityで順次提供する。
Googleは10月28日(日本時間29日)にCarbonを発表した際、まず審査を通ったサイバー防御側の組織だけに提供し、一般向けは「できるだけ早く」としていた(発表時の記事)。約2週間で一般提供に移った形になる。Googleは自社で最も強いモデルと位置づけ、複雑なソフトウェア開発や科学の研究など難しい作業向けとしている。既存のGemini 4 Argonは、ソフトウェア開発や知識作業の大半に引き続き適したモデルと説明した。
API料金は12月1日から入力4ドル、出力20ドル
開発者が自社のサービスに組み込むときのAPI料金は、AIが読み書きする文章の量(トークン)100万単位で、入力2ドル、出力10ドルの導入価格で始まる。Argonと同じ水準だ。Googleのブログによると導入期間は11月30日に終わり、料金ページと開発者ガイドによると12月1日から入力4ドル、出力20ドルになる。10月の発表時は、導入期間の長さを示していなかった。
出力の料金には、答える前に考える過程(思考)のトークンも含まれる。Googleは、CarbonはArgonより多くのトークンを使うと説明しており、同じ単価でも1回の依頼にかかる費用は大きくなりうる。
- 11月30日まで
- 12月1日から
- 入力2 → 4
- 出力(思考を含む)10 → 20
- 一括処理の入力1 → 2
- 一括処理の出力5 → 10
料金ページによると、Gemini APIの無料枠では使えない。同じ入力を繰り返し送ったときの割引(キャッシュ)は自動で適用される方式だけで、100万トークン当たり0.10ドル、12月1日から0.20ドルになる。
使えるのはAPIの有料利用者とUltra契約者
APIは、Google AI StudioとGemini for businessを通じて、料金を払うすべての開発者と企業が使える。開発者ガイドによると、AI StudioではGemini APIの有料枠の利用者とUltraの契約者が使える。
一般の利用者向けは、Ultraの全契約者に、Geminiアプリ、検索のAI Mode、Antigravityで順次提供する。Googleの発表では、Ultra以外のプランでの提供と、提供する国や地域は示されていない。GoogleのクラウドのVertex AIでの提供にも触れていない。
科学者は、ArgonとCarbonをAntigravityの最も利用枠の大きい段階で6か月間無料で使える枠に応募できる。選考は随時で、資格や空き、選考の結果による。サイバー防御側の組織には、引き続きFairwind Programを通じて、サイバー向けのCarbonを提供する。
APIでは、入力と出力を合わせて約100万トークンまで扱える。出力は通常6万5536トークンまでで、時間のかかる処理として送れば、それを超えて出力できる。思考の深さは3段階から選べる。開発者ガイドは、難しい問題では数分かかるため、通信の待ち時間の上限を15〜20分以上にするよう案内している。
Googleは3つの外部評価で首位と主張、他社に及ばない項目も
Googleはブログで、Cursorのコーディング評価「CursorBench 4.0」、Perplexityの「WANDR」、Zapierの業務自動化の評価「AutomationBench」で首位になり、1課題当たりの費用は次点の他社モデルより「2倍超低い」と説明した。ブログに点数は載っていない。図面や画像を読む作業の新しい評価「MKA」では2位だった(MKAの記事)。
モデルカードには、10月時点の評価結果が載っている。AutomationBenchでは、Carbonが53.9%で、AnthropicのClaude Opus 5.5の42.5%、OpenAIのGPT-6 Astraの41.4%を上回った。
一方、同じ表でもCarbonが首位でない項目がある。ソフトウェア開発の課題を解くFrontierSWE 2では、GPT-6 Astraの65.5%に対しCarbonは61.2%だった。パソコンの画面を操作して作業するOSWorld-2.1(オフラインの課題)では、Claude Opus 5.5の87.2%に対しCarbonは81.5%だった。
攻撃への耐性は改善、プロンプトインジェクションは課題
Googleによると、攻撃役のAIエージェントを使った模擬攻撃で、1回の試行で突破される割合はArgonの3.1%から0.8%に下がった。外部のGray Swanの試験では、自動化したサイバー攻撃の依頼が通る割合が9.86%から2.17%に下がった。一方で、文書やWebページに仕込まれた指示にモデルが従ってしまう「プロンプトインジェクション」への耐性は、改善を続ける分野だとしている。
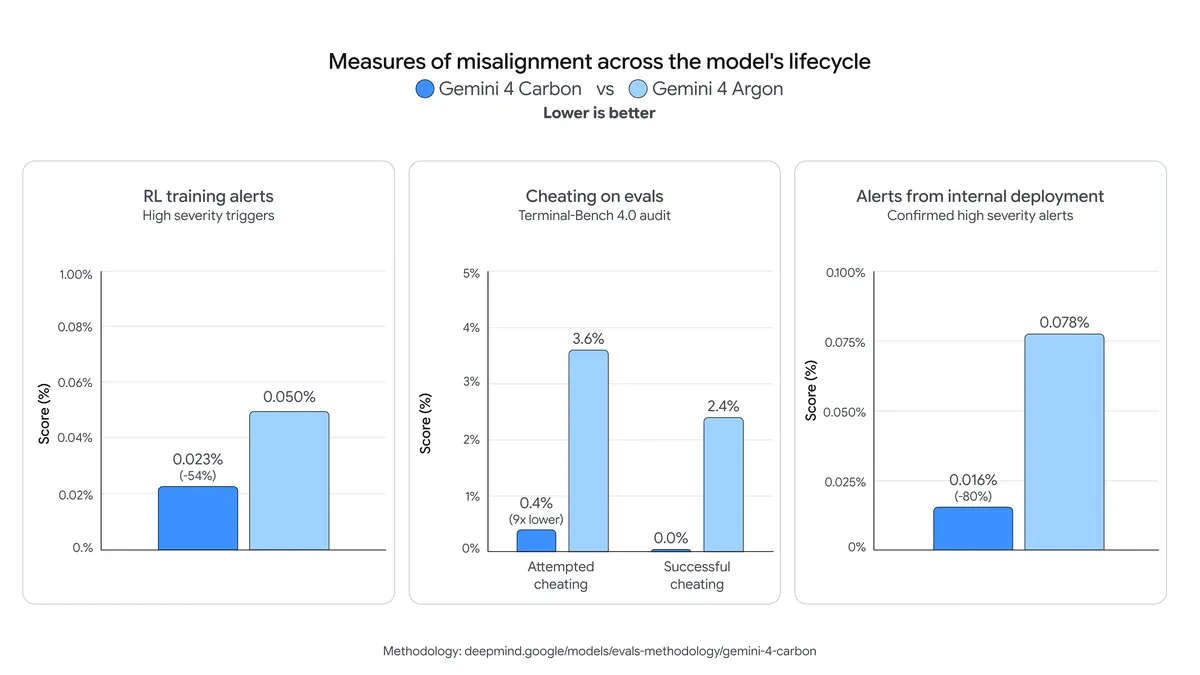
モデルカードは、既知の限界として、誤った内容をもっともらしく答えること(ハルシネーション)、応答が遅くなったり時間切れになったりすること、思考を深くするほどトークンが増えることを挙げた。知識は2026年3月までの情報に基づく。


