
13億と140億の2モデル、目標は1フレーム50ミリ秒以内
米Appleの研究チームは、文章から動画を作るAIモデル「FastFrames」の重み(学習済みのパラメーター)を、Hugging FaceのAppleの組織ページで公開した。公開したのは、13億パラメーターの「FastFrames-S」と140億パラメーターの「FastFrames-L」の2つだ。モデルカードによると、どちらも前のコマに続けて次のコマを順に作る「自己回帰型」の動画拡散モデルで、ノイズを取り除く処理を2回で済ませ、480pの動画を「対話的な待ち時間」で作る。
研究チームは17日(日本時間18日)、論文「FastFrames: Video Generation at Interactive Latency」をarXivに投稿した。著者はAppleとコーネル大学の7人で、筆頭著者がAppleでインターンをしていた間の研究としている。プロジェクトのページは、操作に滑らかに応じるための目標を1フレーム50ミリ秒以下に置く。
Hugging FaceのAPIの表示では、2つのリポジトリの作成は日本時間17日午前2時21分だった。公開に切り替えた日時は示していない。モデルカードからリンクするGitHubの公式リポジトリは、日本時間18日午前6時30分に作られた。
1.3B版はB200 1基で36ミリ秒、14B版はB200 8基で45ミリ秒
論文の概要によると、FastFrames-Sは米NVIDIAのGPU「B200」1基で1フレーム当たり36ミリ秒、1秒当たり28回応答する速さで動く。Appleは、8倍近く遅い最先端のモデルと同等の品質だと説明している。FastFrames-LはB200を8基つないだ環境で1フレーム45ミリ秒、1秒当たり22回応答し、映像の品質と写実性はFastFrames-Sより大きく高いとしている。
モデルカードが示す例では、FastFrames-SがGPU 1基で480pの1フレームを作る時間は計35.4ミリ秒だった。内訳は、映像を作る本体(DiT)の2回の計算が16.1ミリ秒と16.2ミリ秒、記憶の更新が2.2ミリ秒、画素への変換が0.9ミリ秒だ。生成の例は832×480の画素で81フレーム、毎秒16フレームの動画になる。
遅れの半分超は画像への変換と記憶の更新
論文によると、研究チームは既存のモデルの推論を細かく測り、ふだんは変えられない部品として扱われてきた2つの処理が、待ち時間全体の半分超を占めることを見つけた。圧縮した形から画像に戻す処理(VAEの復号)と、それまでのコマの情報をためる「KVキャッシュ」の更新だ。FastFramesはこの2つを軽い仕組みに置き換え、動画を作る本体の計算も実装の工夫で速めた。
FastFrames-Lは、動画生成モデル「Wan2.1」の140億パラメーター版を、既存の手法「Causal Forcing++」の手順で2回の処理で動くモデルに蒸留して作った。学習の途中段階の重みも、最終版とあわせて公開している。FastFrames-Sは、Causal Forcing++の2回で動く生成器をそのまま使い、周りの部品だけを学習した。そのためFastFrames-SのHugging Faceのリポジトリには追加の部品だけが入り、容量は約1.8ギガバイトと、FastFrames-Lの約174ギガバイトより小さい。
利用は研究目的に限り、測定は最新のB200
重みのライセンス「Apple Machine Learning Research Model License」は、利用を研究目的に限る。研究目的は、科学的な知見を進めるための非営利の研究や学術開発と定め、商用の利用、製品の開発、商用の製品やサービスでの利用を含まない。重みから作った派生モデルにも同じ制限がかかる。
FastFramesのコードは「Apple Sample Code License」で公開した。リポジトリに含む「LingBot-World v2」のコードと重みは、元の開発元のCC BY-NC-SA 4.0ライセンスに従う。動かすには、Linux(x86-64)とNVIDIAのGPU、CUDA 12.8に対応したドライバーが要る。
論文は、測定にB200を使ったことを限界の1つに挙げ、端末の上で動かすことを今後の可能性として示した。付録の測定では、NVIDIAのGPU「H100」は構成によりおよそ25〜50%遅い。解像度も480pが前提で、720pではFastFrames-SがB200 1基で127ミリ秒、FastFrames-LがB200 8基で116ミリ秒と、目標の50ミリ秒を超える。
Hugging Faceでは、Apple以外の利用者がFastFrames-Lを使うアプリ(Space)を3つ公開している。21日時点で、FastFrames-Lには488、FastFrames-Sには111の「いいね」が付いた。
既存のモデルにも適用、カメラ操作のLingBotは16倍速く
研究チームは、FastFramesの手法を他の研究チームが公開した2種類のモデルにも当てはめた。キー操作でカメラを動かせる動画モデル「LingBot」と、物理法則に沿ってドラッグした物を動かす「RealWonder」だ。LingBotの13億パラメーター版は、公式の実装で最も速い構成(GPU 2基)の842ミリ秒が、GPU 8基で52ミリ秒になり、16倍速くなった。RealWonderは公式(GPU 1基)の1141ミリ秒が51ミリ秒(GPU 8基)に、LingBotの140億パラメーター版は1373ミリ秒が233ミリ秒(どちらもGPU 8基)に縮んだ。
LingBotとRealWonderが文章から動画を作るFastFramesより遅いのは、ノイズを取り除く処理の回数が多く、1回に複数のコマを作り、操作の条件を処理する計算が加わるためだと論文は説明している。Hugging Faceでは、FastFramesの手法で速めたLingBot 13億パラメーター版の部品も公開した。測定はいずれもB200で、832×480の画素で行った。
Apple自身の比較、速さで上回り「意味」の点数は一部に及ばず
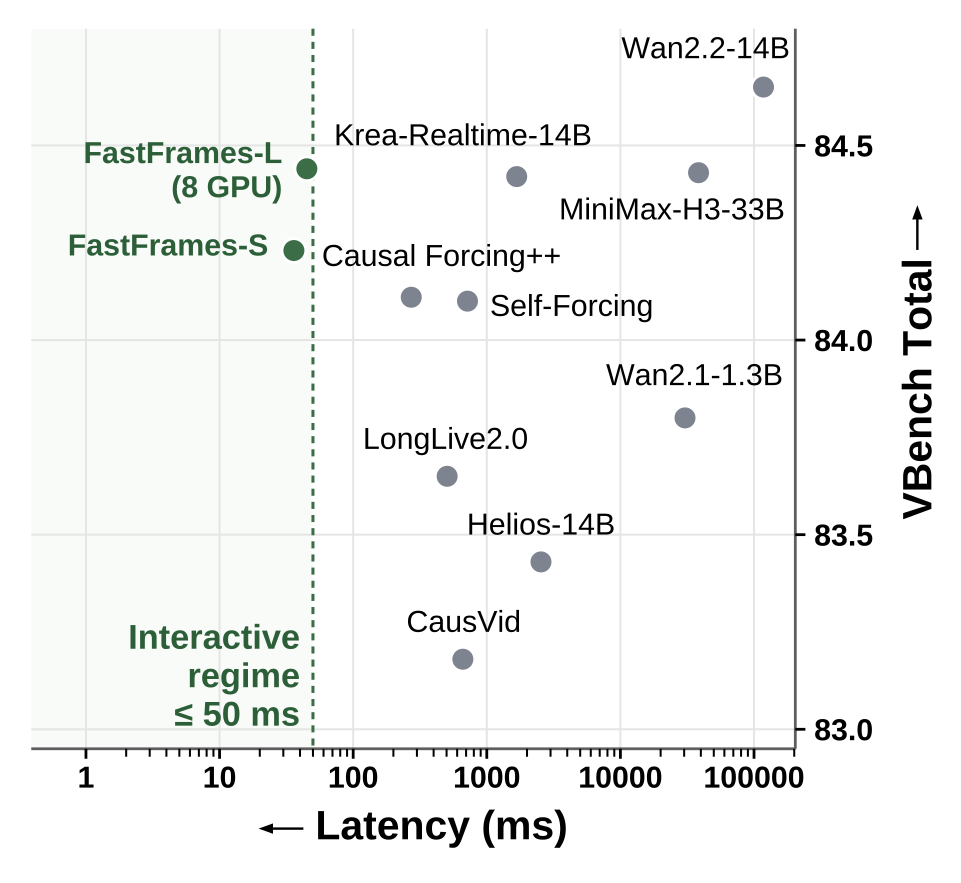
論文の表1は、同じ指示文と乱数の種を使い、およそ480pで、生成の時間と動画の評価指標VBenchの点数を比べた。VBenchは数字が大きいほど良く、総合(Total)、品質(Quality)、意味(Semantic)の3つを示す。測定はB200 1基が基本で、GPU 8基の行は表に記した。
FastFrames-Sの生成時間は36ミリ秒で、同じ13億パラメーターのCausal Forcing++の272ミリ秒より短く、Appleは8倍近く速いと説明している。総合は84.23点でCausal Forcing++の84.11点を上回ったが、意味は79.92点でCausal Forcing++の80.20点、Self-Forcingの81.13点を下回った。FastFrames-L(GPU 1基で158ミリ秒)は、同じ規模のKrea-Realtime(1675ミリ秒)より速く、総合は84.44点とKrea-Realtimeの84.42点を上回った。一方、意味は80.29点で、Krea-Realtimeの81.81点、Wan2.2の81.60点に及ばず、総合でもWan2.2の84.65点を下回った。
| モデル | 種類 | 規模(10億パラメーター) | 生成時間(ミリ秒) | VBench総合 | 品質 | 意味 |
|---|---|---|---|---|---|---|
| Wan2.1 | 双方向 | 1.3 | 30,444 | 83.80 | 84.56 | 80.73 |
| Wan2.2 | 双方向 | 14.3 | 117,734 | 84.65 | 85.41 | 81.60 |
| MiniMax-H3 | 双方向 | 33.1 | 38,454 | 84.43 | 85.17 | 81.47 |
| HunyuanVideo1.5 | 双方向 | 8.3 | 1,555,508 | 83.18 | 84.14 | 79.35 |
| LTX2.5 | 双方向 | 19.0 | 11,264 | 83.62 | 84.78 | 78.96 |
| MAGI1.1 Distilled | 自己回帰 | 23.9 | 19,736 | 82.04 | 83.40 | 76.60 |
| Helios Distilled | 自己回帰 | 14.3 | 2,544 | 83.43 | 84.53 | 79.03 |
| Krea-Realtime | 自己回帰 | 14.3 | 1,675 | 84.42 | 85.08 | 81.81 |
| LongLive2.0 | 自己回帰 | 5.0 | 505 | 83.65 | 84.54 | 80.09 |
| CausVid | 自己回帰 | 1.3 | 662 | 83.18 | 84.15 | 79.31 |
| Self-Forcing | 自己回帰 | 1.3 | 717 | 84.10 | 84.84 | 81.13 |
| Causal Forcing++ | 自己回帰 | 1.3 | 272 | 84.11 | 85.09 | 80.20 |
| FastFrames-S | 自己回帰 | 1.3 | 36 | 84.23 | 85.30 | 79.92 |
| FastFrames-S(GPU 8基) | 自己回帰 | 1.3 | 14 | 84.23 | 85.30 | 79.92 |
| FastFrames-L | 自己回帰 | 14.3 | 158 | 84.44 | 85.48 | 80.29 |
| FastFrames-L(GPU 8基) | 自己回帰 | 14.3 | 45 | 84.44 | 85.48 | 80.29 |
Self-Forcingの生成時間について、論文は、同モデルが公表する値はKVキャッシュがたまる前の軽いコマも含めた平均で、Appleはキャッシュが満ちた状態で測ったと注記している。第三者による同じ条件での評価は確認できていない。


